
Random Forest Monitoreo de Bosques: 5 Límites Críticos + Soluciones Probadas

- Preparar datos: Bandas Sentinel-2 + puntos de entrenamiento
- Entrenar Random Forest: Algoritmo de votación con 100-500 árboles
- Extraer probabilidades: No solo clase binaria, también confianza
- Validar por rangos: Random Forest monitoreo de bosques debe testearse por banda de probabilidad
- Generar mapas operacionales: Integrar Random Forest en pipeline de toma decisiones
Detalles técnicos: Este artículo te muestra cómo extraer y usar las probabilidades de Random Forest monitoreo de bosques para construir mapas forestales más precisos y validables con Sentinel-2. Diferencia entre usar Random Forest monitoreo de bosques solo con clases vs. probabilidades completas.
Índice de contenidos: Random Forest monitoreo de bosques
- ¿Qué es Random Forest en monitoreo de bosques? Algoritmo clave en clasificación forestal
- Clases vs Probabilidades: la diferencia clave en Random Forest monitoreo de bosques
- ¿Cómo genera Random Forest las probabilidades en clasificación forestal?
- Interpretación de probabilidades de Random Forest en monitoreo de bosques con Sentinel-2
- 5 Limitaciones Críticas de Random Forest en monitoreo de bosques
- Limitación 1: Fragmentación de píxeles aislados en Random Forest
- Limitación 2: Dependencia de datos de entrenamiento estacionales
- Limitación 3: Probabilidades no son incertidumbre real calibrada
- Limitación 4: Saturación en infrarrojo cercano de Sentinel-2
- Limitación 5: Problemas temporales y cambio estacional
- Aplicación práctica: de probabilidades de Random Forest a mapas operacionales validados
¿Qué es Random Forest en monitoreo de bosques? Algoritmo clave en clasificación forestal
Random Forest es un algoritmo de aprendizaje automático que combina múltiples árboles de decisión para clasificar píxeles de imágenes satelitales. Los estudios recientes demuestran la efectividad de Random Forest en clasificación forestal, especialmente cuando se usa Random Forest monitoreo de bosques con datos de Sentinel-2. Random Forest en teledetección ha ganado popularidad porque:
- Maneja múltiples bandas espectrales simultáneamente (rojo, infrarrojo cercano, infrarrojo de onda corta)
- No requiere normalización previa de los datos
- Proporciona importancia de variables (qué bandas importan más)
- Genera probabilidades, no solo clasificaciones binarias
- Es relativamente rápido incluso para millones de píxeles
Pero aquí está el punto crucial: muchos usuarios aplican Random Forest monitoreo de bosques y solo usan la predicción final binaria (bosque/no bosque). Es como construir un mapa forestal con un mapa binario cuando Random Forest ya te ha generado un continuo de probabilidades. Los usuarios que dominan Random Forest para monitoreo de bosques saben que ignoring las probabilidades es desperdiciar información valiosa.
Clases vs Probabilidades: la diferencia clave en Random Forest monitoreo de bosques
Un píxel clasificado como “bosque” por Random Forest monitoreo de bosques no es lo mismo que un píxel con 95% de probabilidad de ser bosque según Random Forest. Esta diferencia es crítica para la validación científica y las decisiones de gestión forestal. Cuando usas Random Forest para monitoreo de bosques, las probabilidades son tan importantes como la clasificación final.
Mira la diferencia en esta tabla: cómo Random Forest monitoreo de bosques con clases vs probabilidades cambia radicalmente tu interpretación:
| Aspecto | Clase (binaria) | Probabilidad |
|---|---|---|
| Información | Sí/No | 0 a 100% de certeza |
| Incertidumbre | No capturada | Completamente capturada |
| Píxeles débiles (51-55%) | Se clasifican como bosque | Se etiquetan como de baja confianza |
| Uso en validación | Solo matriz de confusión binaria | Curva ROC, AUC, análisis de umbral |
| Decisiones de gestión | Blanco y negro | Nuances y umbrales adaptativos |
Considera este escenario: tienes dos píxeles, ambos clasificados como “bosque”:
Píxel B: 52% de probabilidad de ser bosque (probablemente transición bosque-herbácea)
Sin las probabilidades, ambos se ven idénticos en tu mapa. Con las probabilidades, puedes:
- Identificar píxeles de baja confianza para verificación en terreno
- Aplicar filtros espaciales solo donde sea necesario
- Construir capas de incertidumbre para reportes
- Ajustar umbrales según tu caso de uso (conservación vs. aprovechamiento)
¿Cómo genera Random Forest las probabilidades en clasificación forestal?
Random Forest no es un algoritmo “caja negra” cuando trabajas en monitoreo de bosques. La lógica interna de cómo Random Forest calcula probabilidades es directa y transparente:
- Se entrenan 100-500 árboles de decisión independientes (típicamente)
- Cada árbol llega a una predicción: bosque (1) o no bosque (0)
- La probabilidad final = (árboles que votaron “bosque”) / (total de árboles)
- Si 85 de 100 árboles predicen bosque → probabilidad = 0.85
Es votación democrática pura. Random Forest monitoreo de bosques funciona porque cada árbol da su voto independiente, y ese consenso de votos contiene toda la incertidumbre del modelo. Cuando estudias Random Forest clasificación forestal a nivel profundo, comprendes que esta votación es lo que hace único a Random Forest monitoreo de bosques comparado con otros algoritmos.
# Pseudocódigo - Random Forest probabilidades
# Documentación oficial: https://scikit-learn.org/stable/modules/generated/sklearn.ensemble.RandomForestClassifier.html
from sklearn.ensemble import RandomForestClassifier

rf = RandomForestClassifier(n_estimators=200, random_state=42)
rf.fit(X_train, y_train)

# Predicción de clase
y_pred = rf.predict(X_test)  # [0, 1, 1, 0, ...]

# Predicción de probabilidades
y_proba = rf.predict_proba(X_test)  # [[0.15, 0.85], [0.02, 0.98], ...]
# Columna 0: probabilidad de NO ser bosque
# Columna 1: probabilidad de SER bosque
Interpretación de probabilidades de Random Forest en monitoreo de bosques con Sentinel-2
No todas las probabilidades de Random Forest significan lo mismo. En monitoreo de bosques con Sentinel-2, cuando usas Random Forest para clasificación forestal, verás patrones predecibles en los rangos de probabilidad. Estudios recientes en Remote Sensing demuestran que las probabilidades de Random Forest en clasificación forestal correlacionan directamente con exactitud validada en terreno, haciendo que Random Forest monitoreo de bosques sea altamente predecible:
Rango 95-100%: Bosque muy seguro
Vegetación densa, infrarrojo cercano muy alto, espectro característico de dosel cerrado. Típico de bosque primario o regeneración avanzada. Estos píxeles son candidatos para validación independiente como puntos “de referencia verdadera”.
Rango 75-95%: Bosque probable
La mayoría de tu mapa forestal cae aquí. Bosques secundarios, plantaciones, regeneración media. Suficientemente seguros para reportes operacionales pero merecen revisión en bordes y zonas de transición.
Rango 50-75%: Zona gris
Aquí viven las transiciones: bosque ralo, herbácea con arbustos dispersos, áreas con sombra topográfica. Si necesitas precisión por hectárea, estos píxeles requieren trabajo adicional.
Rango 25-50%: Probablemente no es bosque
Pero hay duda. Puede ser agua superficial, nubes ligeras no detectadas, o zonas muy heterogéneas. Merece revisión si tus umbrales de clasificación son conservadores.
Rango 0-25%: Casi seguro que no es bosque
Agua, cultivos, zona urbana, suelo desnudo. Muy pocos falsos positivos aquí.
Validación independiente: el estándar científico para Random Forest monitoreo de bosques
La validación independiente es el protocolo estándar en Random Forest clasificación forestal. Cuando entrenas Random Forest monitoreo de bosques, nunca debes validar con los mismos puntos de entrenamiento. FAO establece directrices internacionales para validación de mapas forestales que aplican también a Random Forest en teledetección. El protocolo correcto es:
- Dividir datos: 70% entrenamiento (para Random Forest), 30% validación independiente
- Usar partición espacial: Random Forest monitoreo de bosques debe testearse en áreas geográficas diferentes
- Validar por rangos de probabilidad: Esto es especialmente crítico con Random Forest
- Calcular matriz de confusión e intervalos de confianza (IC)
🎯 Consejo práctico:
En tus primeros análisis con Random Forest, guarda todas las probabilidades como una banda raster separada. Luego explora rangos con filtros. No apliques un umbral fijo (p.ej. 50%) sin antes mapear cada rango y validarlo visualmente.
5 Limitaciones Críticas de Random Forest en monitoreo de bosques: cuándo necesitas Deep Learning
Random Forest es poderoso para monitoreo de bosques pero tiene limitaciones reales. Estos son los techos que enfrenta Random Forest en clasificación forestal:
Limitación 1: Fragmentación de píxeles aislados en Random Forest
Random Forest clasifica píxel por píxel sin considerar contexto espacial. Un píxel bosque rodeado de 8 píxeles no-bosque se mantiene clasificado como bosque en Random Forest monitoreo de bosques. Esto genera mapas que parecen “ruido” fragmentado. Este es un problema conocido en Random Forest teledetección.
Solución: U-Net incorpora contexto espacial procesando ventanas de 128×128 píxeles. Pero requiere significativamente más datos de entrenamiento que Random Forest monitoreo de bosques simple.
Limitación 2: Dependencia de datos de entrenamiento estacionales
Si tus puntos de validación fueron recolectados en una estación específica (ej. máxima verdor en junio), Random Forest aprende esa firma espectral particular. Aplicado a otra fecha, puede fallar.
Solución: Entrena con series temporales o múltiples fechas. Esto es costoso pero más robusto.
Limitación 3: Probabilidades no son incertidumbre real calibrada
Una probabilidad de 90% no significa “90% de certeza verdadera”. Significa “90% de los árboles votaron así”. Si tu conjunto de entrenamiento está sesgado, todas las probabilidades se sesgan juntas.
Solución: Calibra tus probabilidades con validación independiente. Comprueba si píxeles con 80% de probabilidad realmente tienen 80% de tasa de éxito.
Limitación 4: Saturación en infrarrojo cercano de Sentinel-2
Sentinel-2 tiene resolución radiométrica de 12 bits. El infrarrojo cercano se satura en bosques muy densos, donde todos los píxeles tienen valores casi idénticos. Random Forest no puede diferenciar entre bosque denso A y bosque denso B si espectralmente son iguales.
Limitación 5: Problemas temporales y variabilidad estacional
Random Forest entrenado en una estación específica (p.ej. máxima verdor en junio) puede fallar completamente cuando se aplica a otras épocas del año. Las firmas espectrales de bosques cambian significativamente entre estaciones. En monitoreo de bosques operacional, Random Forest requiere múltiples fechas de entrenamiento para ser robusto temporalmente.
Solución: Entrena Random Forest monitoreo de bosques con datos de mínimo 2-3 estaciones diferentes. Esto aumenta la complejidad pero hace que tu modelo sea verdaderamente operacional todo el año.
Aplicación práctica: de probabilidades de Random Forest a mapas operacionales validados
Convertir Random Forest monitoreo de bosques de herramienta teórica a sistema operacional requiere 4 pasos clave. Este protocolo sigue estándares internacionales de validación. Global Forest Watch recomienda explícitamente este flujo de trabajo cuando usas Random Forest para monitoreo de bosques profesional.
Paso 1: Entrenar y exportar probabilidades
# Exportar como GeoTIFF
# Docs: https://rasterio.readthedocs.io/en/stable/
from rasterio.transform import from_bounds
import rasterio

# Reshape probabilidades a la geometría original
proba_raster = y_proba[:, 1].reshape(height, width)

# Guardar
with rasterio.open(
    'random_forest_proba.tif',
    'w',
    driver='GTiff',
    height=height,
    width=width,
    count=1,
    dtype=rasterio.uint8,  # 0-255
    crs='EPSG:32718',
    transform=transform
) as dst:
    dst.write((proba_raster * 255).astype(uint8), 1)
Tip SEO: Este pipeline completo (preprocesamiento → entrenamiento → exportación de probabilidades) se cubre en profundidad en nuestro curso Python e IA para Ecología y Bosques, con notebooks Colab ejecutables y datasets reales de Sentinel-2.
Paso 2: Explorar umbrales
# Para cada umbral, calcular área total
umbrales = [50, 60, 70, 80, 90]
for umbral in umbrales:
    mapa_binario = (proba_raster >= umbral/100).astype(int)
    area_bosque_ha = mapa_binario.sum() * 100 / 10000  # Sentinel = 100 m²/píxel
    print(f"Umbral {umbral}%: {area_bosque_ha:.0f} ha")

# Resultado esperado: áreas disminuyen conforme sube umbral
# Ej:  Umbral 50%: 45,000 ha
#      Umbral 70%: 42,000 ha
#      Umbral 90%:  38,000 ha
🔗 Infraestructura: La descarga automática de Sentinel-2, preprocesamiento y gestión de nubes vive en Google Earth Engine. Aprende el flujo completo en Monitoreo de Bosques con Google Earth Engine.
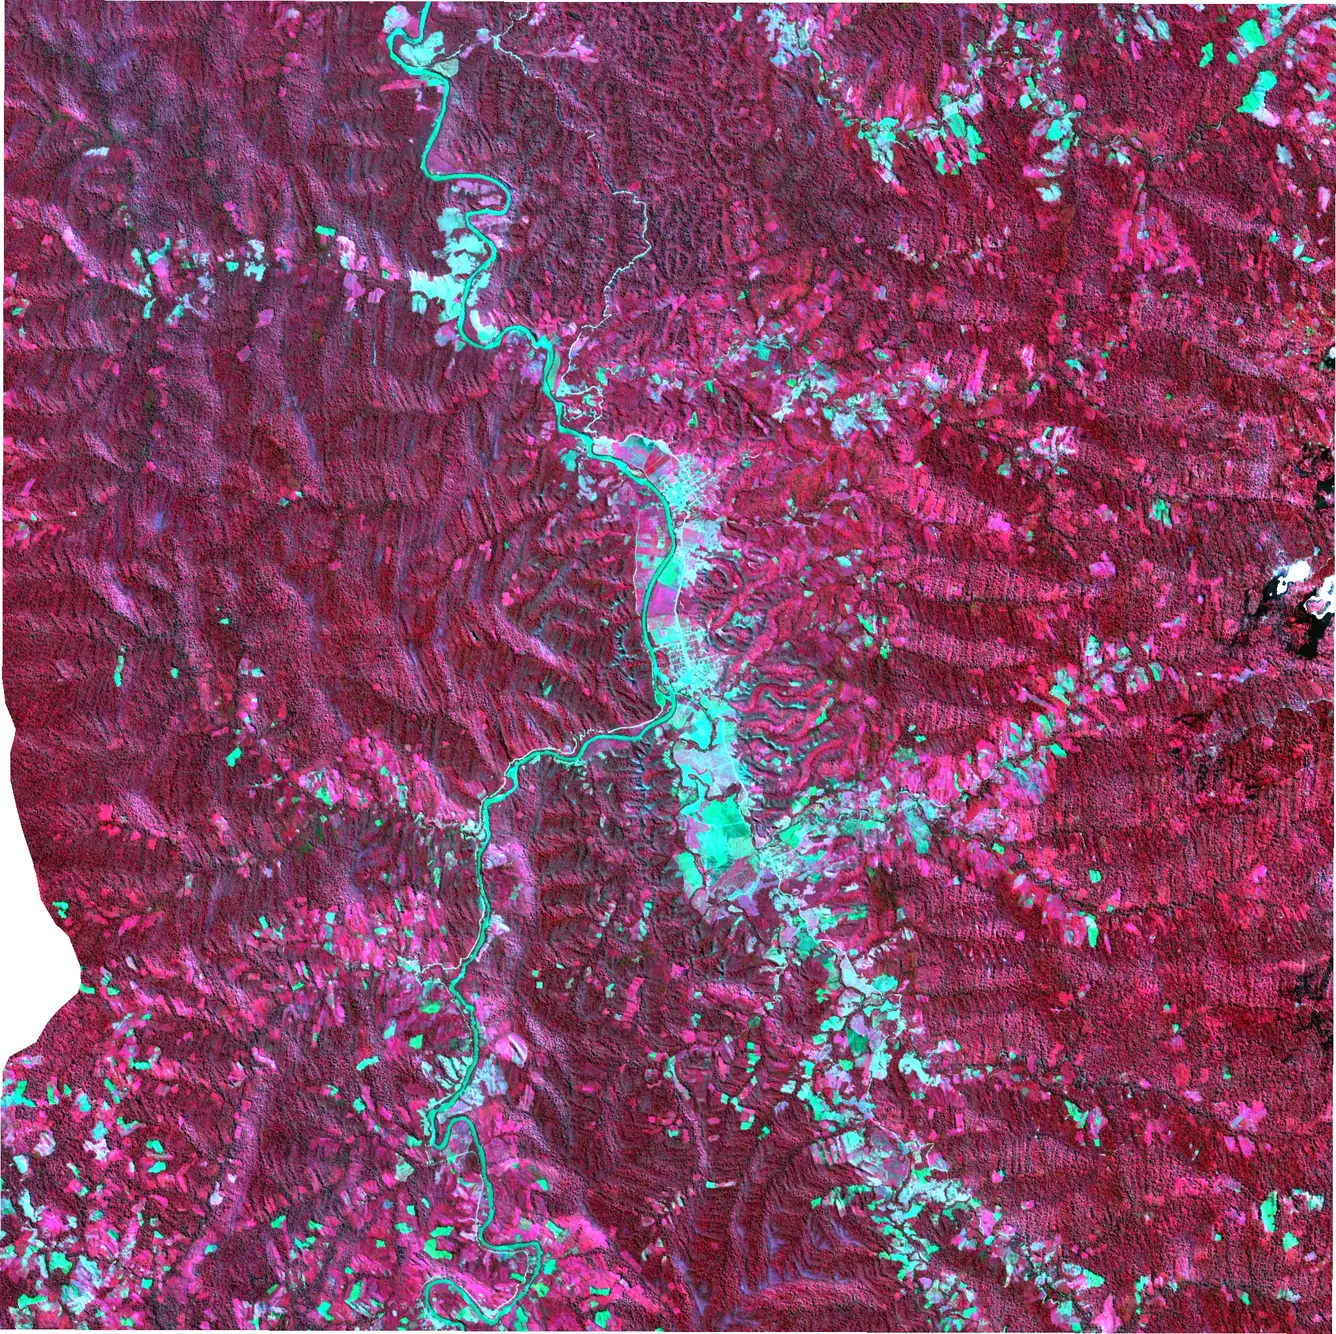
Figura 3: Canal infrarrojo cercano (NIR) de Sentinel-2 para Random Forest monitoreo de bosques. Los valores altos (magenta/cyan) indican vegetación densa. Río sinuoso en cyan. Alto Biavo 2019 – este análisis espectral alimenta las probabilidades de Random Forest.
Paso 3: Validación independiente por rango
Divide tus puntos de validación por rango de probabilidad:
- Rango 90-100%: Esperas 95%+ de exactitud. Si no, tu modelo sobrestima.
- Rango 70-90%: Objetivo: 80%+ de exactitud.
- Rango 50-70%: Zona débil. Esperas 50-70% de exactitud.
- Rango <50%: Casi nunca son bosque. Verifica falsos positivos.
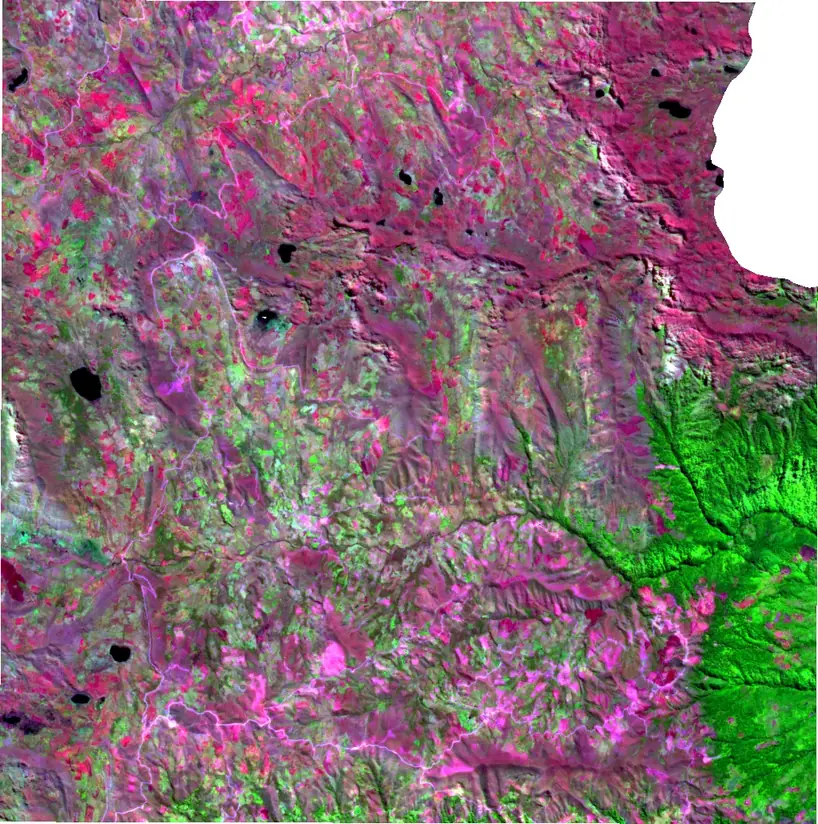
Figura 2: Random Forest monitoreo de bosques – RGB falso (NIR-R-G) Sentinel-2 Panao 2019-2020. Bosque denso en magenta, transiciones en rosa, agricultura en verde. Resolución 10m.

Comparación visual: mapa binario (izq) vs mapa de probabilidades (der). Note cómo las probabilidades revelan píxeles fronterizos con baja confianza.
Paso 4: Integración en pipeline
Las probabilidades no son solo para análisis. Incluye en tu flujo de trabajo:
- Reportes: Área de bosque seguro (>80%) vs área probable (>50%)
- Mapas de incertidumbre: Zonas rojas donde Random Forest es débil
- Estratificación: Usa probabilidades para priorizar puntos de verificación en terreno
- Series temporales: Detecta cambios no en el mapa binario, sino en la distribución de probabilidades año a año
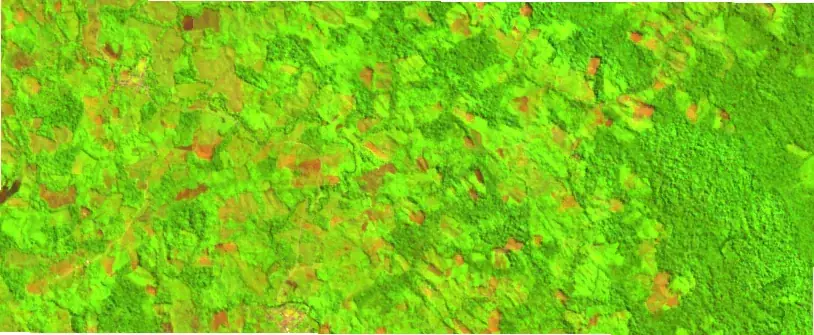
Figura 4: Índice de agricultura derivado de análisis espectral Random Forest. Verde=agricultura productiva, naranja/marrón=suelo/sin cultivo. Random Forest usa estos índices como features para diferenciar cobertura.
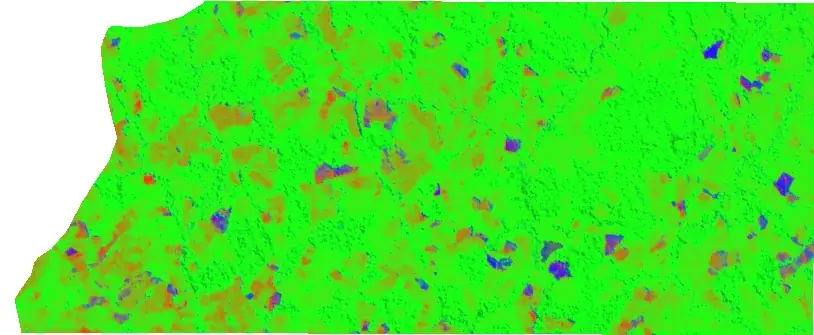
Figura 5: Fracciones espectrales desagregadas: Verde (GV-Vegetación Fotosintética), No-Fotosintético (NPV-ramas/suelo senescente), Suelo. Random Forest captura estas fracciones como probabilidades, no como valores binarios simples.
Conclusión: Random Forest monitoreo de bosques como línea base robusta
Random Forest no solo produce una clase binaria. Random Forest monitoreo de bosques produce un voto democrático de cientos de árboles, y ese voto es exponencialmente más informativo que una clasificación binaria simple. Cuando implementas Random Forest monitoreo de bosques correctamente, estás construyendo mapas forestales que hablan en términos de confianza, no de certeza.
Los mejores mapas forestales que hemos validado en Big Data Academy no son aquellos con mayor accuracy global, sino los que mantienen explícitas las probabilidades de Random Forest monitoreo de bosques y las validan por rango independientemente. Esto requiere trabajo adicional en monitoreo de bosques, pero transforma Random Forest de una herramienta estadística pura a un producto operacional real para toma de decisiones en la gestión forestal.
Si construyes un sistema de monitoreo de bosques operacional, comienza con Random Forest monitoreo de bosques como tu línea base sólida y confiable. Luego, añade capas avanzadas: análisis espectral con NDFI para detección de degradación, contexto espacial con U-Net para reducir ruido, validación temporal para detectar cambios reales. Pero conserva siempre las probabilidades de Random Forest. Son tu brújula hacia mapas confiables y científicamente defendibles. Random Forest monitoreo de bosques es donde comienza todo.
📈 Análisis espacial avanzado: Para ir más allá de Random Forest (U-Net, contexto espacial, análisis multitemporal), nuestro curso Ecología Espacial con Google Earth Engine cubre series temporales, validación de cambios e integración de múltiples sensores.
Domina Random Forest + Sentinel-2 en tu workflow forestal
Aprende a entrenar modelos robustos, interpretar probabilidades y validar mapas con datos reales en nuestro curso “Inteligencia Artificial para Monitoreo de Bosques”.
Ver Curso CompletoDomina Random Forest para Monitoreo Forestal
Probabilidades, umbrales, validación y series temporales. Aprende los 5 pasos operacionales para desplegar Random Forest monitoreo de bosques en tu flujo de trabajo con Sentinel-2 y Google Earth Engine.
Aprende Random Forest + IA en práctica: Taller de Teledetección
Este artículo cubre la teoría de Random Forest. En nuestro Taller de Teledetección con IA: Monitoreo de Bosques e Incendios (2 días), entrenarás modelos desde cero con datos reales de Sentinel-2, validarás mapas en terreno y verás cómo Random Forest se integra en pipelines operacionales de monitoreo forestal.
Práctico. Sin hype. Diseñado para profesionales ambientales, técnicos forestales e ingenieros que monitorean bosques e incendios.
Conoce el Taller →