
De archivos dispersos a un dataset espacialmente alineado, reproducible y listo para Machine Learning y Deep Learning.
Un cubo de datos geoespacial permite pasar de bandas, índices y variables dispersas a una estructura espacialmente alineada y reproducible. En monitoreo de bosques, esto facilita que un modelo de inteligencia artificial reciba las variables con la misma grilla, extensión y sistema de referencia.
En esta guía vas a entender qué es un cubo de datos geoespacial, por qué transforma la calidad de tus mapas forestales y qué tipo de información contiene. Si trabajas con imágenes Sentinel-2 y quieres aplicar machine learning o deep learning al monitoreo de bosques, este concepto es fundamental.

El cubo convierte capas dispersas en un dataset coherente para IA
El problema: una carpeta con 50 TIFF no es un dataset para IA
Este es un escenario frecuente: bandas Sentinel-2 en varios archivos, índices calculados por separado, variables topográficas en otra ruta y máscaras de calidad almacenadas de forma independiente.
Trabajar así no es incorrecto por sí mismo, pero aumenta el riesgo de desalineaciones, diferencias de extensión, resoluciones inconsistentes, valores faltantes y errores de trazabilidad. Cuando el flujo crece, también se vuelve más difícil reproducir exactamente qué variables entraron al modelo.
El problema, por tanto, no es “tener TIFF”. El problema es no contar con una estructura de datos coherente y documentada. Un cubo geoespacial es una forma práctica de resolverlo.
Qué es un cubo de datos geoespacial para monitoreo de bosques
Un cubo de datos geoespacial organiza variables que comparten una referencia espacial común. En nuestro pipeline, las variables predictoras se almacenan en un NetCDF y se manejan con xarray en Python.
La idea central es sencilla: para una misma posición espacial, el modelo puede consultar bandas espectrales, fracciones derivadas del análisis de mezcla, índices y topografía sin reconstruir manualmente cada relación entre archivos.
NetCDF es muy utilizado en ciencias ambientales y geociencias; Zarr es otra alternativa especialmente útil para flujos grandes o paralelos. El formato elegido depende del volumen de datos y de la arquitectura del proyecto.
Qué información contiene un cubo de datos para monitoreo de bosques
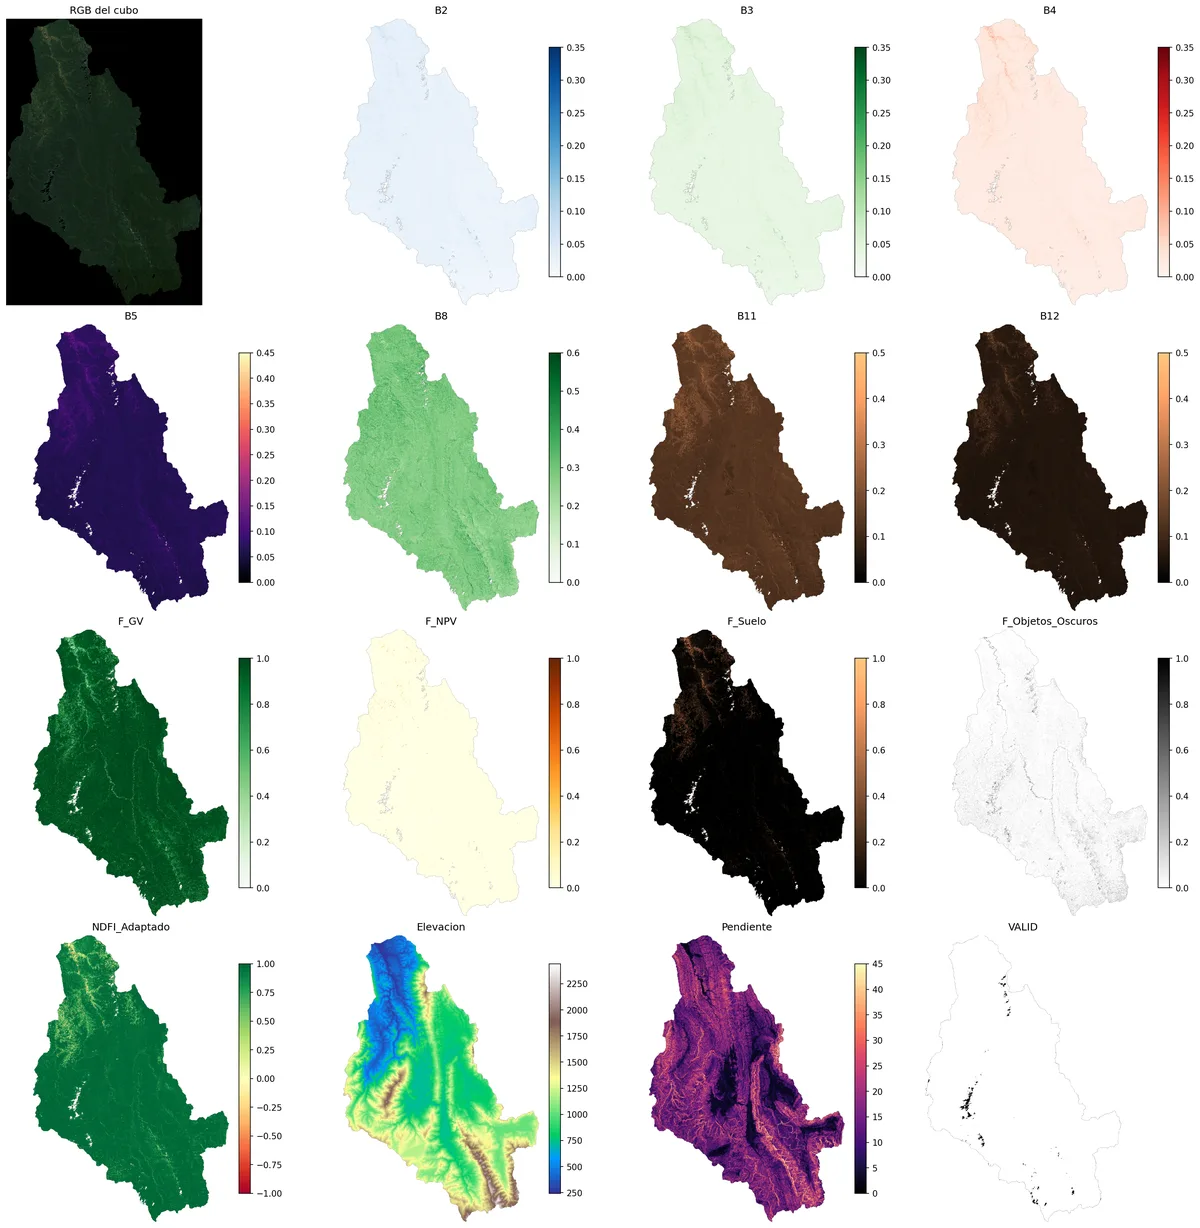
En el pipeline de Monitoreo de Bosques de Big Data Academy, el cubo de trabajo contiene 14 variables predictoras. Todas se llevan a una grilla común para facilitar el entrenamiento y la inferencia.
Información espectral
Las bandas de Sentinel-2 describen la respuesta espectral de la superficie en regiones visibles, infrarrojo cercano y SWIR. Son la base del análisis, pero coberturas distintas pueden presentar respuestas parcialmente solapadas.
Información subpíxel
Las fracciones espectrales representan la contribución relativa de componentes como vegetación verde (GV), vegetación no fotosintética (NPV), suelo y objetos oscuros. Estas variables aportan información complementaria a las bandas e índices tradicionales y permiten describir mejor la composición espectral de cada píxel.
Esto no significa que una fracción o un índice detecte universalmente degradación forestal por sí solo. Su utilidad depende del tipo de bosque, la calidad de los endmembers, la fecha, la resolución y la validación del producto.
Información topográfica
Elevación y pendiente aportan contexto del terreno. No sustituyen la señal espectral, pero pueden ayudar al modelo a diferenciar coberturas que aparecen en contextos geomorfológicos distintos.
Máscara de validez
La máscara VALID es una variable auxiliar para identificar píxeles utilizables. En nuestro flujo no forma parte de las 14 variables predictoras; se utiliza para controlar qué observaciones deben entrar o excluirse del procesamiento.
Por qué un cubo de datos geoespacial mejora el flujo de trabajo
La principal ventaja del cubo no es que un formato de archivo “aumente el accuracy” automáticamente. Su valor está en la consistencia del dataset.
Cuando todas las variables están alineadas y documentadas, es más sencillo:
- extraer muestras de entrenamiento de forma reproducible;
- aplicar las mismas variables durante entrenamiento e inferencia;
- detectar valores faltantes o píxeles inválidos;
- controlar proyección, resolución y extensión;
- repetir el experimento sin reconstruir manualmente decenas de archivos.
La mejora de un modelo dependerá de la calidad y relevancia de las variables, del diseño del muestreo, de la partición espacial, del algoritmo y de la validación. El cubo hace que ese proceso sea más ordenado y reproducible; no reemplaza esos pasos.
Cubo de datos vs archivos sueltos: qué cambia realmente
Comparar “archivos sueltos” contra “cubo” como si fueran dos algoritmos sería engañoso: el formato de almacenamiento no genera por sí mismo una ganancia de precisión.
Lo que cambia es la ingeniería del flujo. Con un cubo bien construido podemos garantizar que el modelo reciba exactamente las variables esperadas en la misma posición espacial y bajo reglas de preprocesamiento documentadas.
En nuestro caso, el cubo de Alto Biavo se utiliza como base para un flujo híbrido en el que Random Forest trabaja con las variables predictoras y una CNN residual contextual incorpora además las probabilidades del Random Forest. Las métricas de cada etapa deben evaluarse por separado y, finalmente, mediante validación independiente; no atribuimos esas métricas al formato NetCDF en sí.
Quién necesita un cubo de datos geoespacial
Si haces clasificación de cobertura, un cubo es especialmente útil cuando trabajas con muchas variables y necesitas garantizar que todas coincidan espacialmente.
Si trabajas con series temporales, una estructura multidimensional facilita mantener una convención común entre fechas y variables.
Si aplicas Deep Learning, necesitas tensores espacialmente alineados. Un cubo NetCDF/xarray es una forma muy conveniente de prepararlos, aunque no es la única arquitectura posible.
Si buscas reproducibilidad, centralizar variables, coordenadas, atributos y reglas de validez simplifica la documentación y reduce pasos manuales.
Si quieres entender cómo esta estructura se integra en un flujo más amplio de ciencia de datos geoespaciales, revisa nuestra guía sobre el tema.
Cómo aprender a construir tu propio cubo de datos geoespacial
Esta guía explicó qué es un cubo de datos geoespacial y qué función cumple dentro de un pipeline de monitoreo forestal. El siguiente paso es observar cómo se construye y cómo se conecta con el modelamiento.
En nuestro seminario gratuito mostramos un caso aplicado a la Amazonía peruana y explicamos cómo bandas, fracciones espectrales, índices y topografía pasan de ser capas separadas a formar un dataset preparado para inteligencia artificial.
En el curso completo desarrollamos el flujo paso a paso: preparación de imágenes, construcción del cubo, entrenamiento del modelo y validación del mapa final.
Lleva este flujo a un caso real en nuestro seminario gratuito
Si trabajas con Sentinel-2, Python, Google Earth Engine o modelos de inteligencia artificial aplicados al ambiente, en el seminario gratuito mostramos cómo estas piezas se integran dentro de un flujo de trabajo reproducible para monitoreo de bosques y análisis ambiental.
La idea no es enseñarte una colección de comandos aislados, sino mostrarte cómo pasar de imágenes y variables dispersas a un proceso estructurado: preparación de datos, construcción del dataset, modelamiento y validación.
Reserva tu lugar
Completa el formulario y recibe la información de acceso.
¿Qué ruta seguir después?
Este artículo se encuentra en la intersección entre teledetección, ciencia de datos e inteligencia artificial. Según el tipo de problema que quieras resolver, puedes profundizar por una de estas tres rutas:
Python e IA para Ecología y Bosques
Para quienes quieren llevar datos ambientales a Python y trabajar con ciencia de datos, machine learning e inteligencia artificial aplicada a problemas ecológicos y forestales.
Ver curso de Python e IA →Monitoreo de Bosques con Google Earth Engine
Si tu interés principal es el monitoreo forestal, esta ruta profundiza en procesamiento satelital, análisis de coberturas y flujos de trabajo aplicados directamente a bosques.
Ver curso de Monitoreo de Bosques →Ecología Espacial con Google Earth Engine
Para quienes buscan analizar fragmentación, conectividad, patrones espaciales y procesos ecológicos desde una perspectiva territorial.
Ver curso de Ecología Espacial →Preguntas frecuentes sobre cubos de datos geoespaciales
¿Un cubo de datos geoespacial es lo mismo que un raster multibanda?
No necesariamente. Un raster multibanda puede almacenar varias bandas en una misma grilla, mientras que un cubo geoespacial puede representar múltiples variables y dimensiones con coordenadas y metadatos explícitos. En la práctica, ambos conceptos pueden solaparse, pero un cubo suele orientarse a análisis multidimensional y reproducible.
¿Qué formato se usa para un cubo de datos geoespacial?
El estándar en ciencia de datos ambiental es NetCDF (.nc), manejado con xarray en Python. También se usan Zarr y GeoTIFF multibanda, pero NetCDF es el más flexible para cubos con muchas variables heterogéneas.
¿Necesito una computadora potente para trabajar con cubos?
No. En nuestro pipeline todo corre en Google Colab, que es gratuito y funciona en la nube. El cubo de una provincia se procesa en 2-4 horas sin necesidad de hardware propio.
¿Puedo hacer un cubo de datos geoespacial con datos Landsat?
Sí. La estructura del cubo es independiente del sensor. Lo que cambia son las bandas disponibles y la resolución, pero la lógica de organización es la misma.
¿Cuántas variables debería tener mi cubo?
Depende del problema. Para monitoreo de bosques, lo importante no es la cantidad, sino que cada variable aporte información que las demás no tienen. Variables redundantes empeoran el modelo en vez de mejorarlo. En nuestro curso enseñamos exactamente cuáles incluir y por qué.