
Distribución de especies con Python e IA: 7 claves para modelar hábitat y nicho probable
La distribución de especies con Python e IA permite integrar registros biológicos, variables ambientales y modelos predictivos para identificar áreas potencialmente favorables para una especie.
Pero producir un mapa no es suficiente. Un modelo ecológico útil debe partir de buenos datos, incorporar variables ambientalmente coherentes y demostrar que puede generalizar hacia territorios que no utilizó durante el entrenamiento.
En esta guía veremos siete aspectos fundamentales para pasar de observaciones biológicas a mapas de idoneidad ambiental con una interpretación ecológica rigurosa.
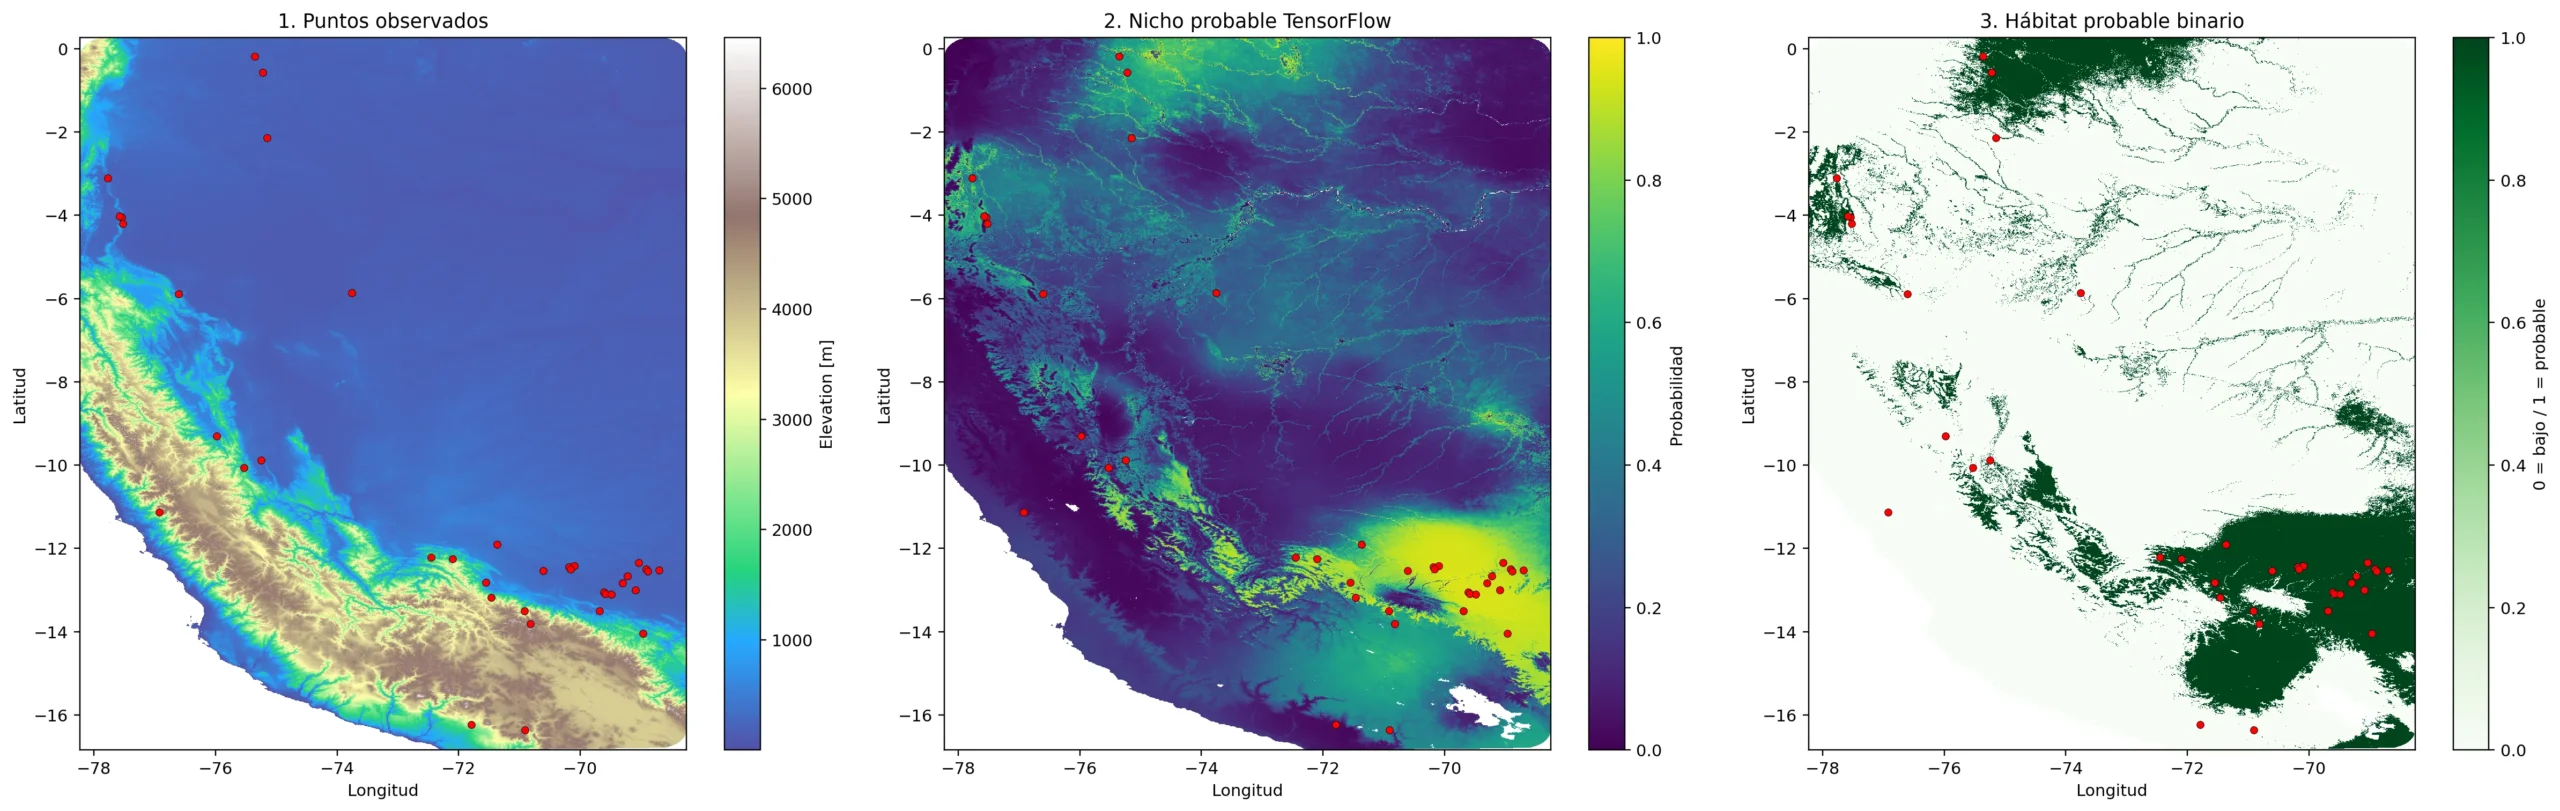
¿Cómo funciona la distribución de especies con Python e IA?
Supongamos que conocemos distintos lugares donde una especie ha sido registrada. Cada registro se encuentra asociado con determinadas condiciones de temperatura, precipitación, elevación, vegetación y cobertura terrestre.
Un modelo puede analizar esas relaciones y estimar qué otros territorios presentan condiciones ambientales semejantes.
De esta manera, la distribución de especies con Python e IA transforma registros biológicos en una hipótesis espacial sobre dónde podrían existir condiciones favorables para la especie.
Hábitat observado, nicho probable y distribución potencial
Aunque están relacionados, estos conceptos no representan exactamente lo mismo.
1. Los registros biológicos determinan la calidad del punto de partida
Cualquier proyecto de distribución de especies con Python e IA necesita comenzar con registros biológicos confiables.
Una gran cantidad de observaciones no garantiza necesariamente una buena representación ecológica. Antes de entrenar un modelo conviene revisar:
- exactitud de las coordenadas;
- identificación taxonómica;
- registros duplicados;
- errores de georreferenciación;
- fecha de observación;
- concentración espacial del muestreo;
- sesgos relacionados con accesibilidad.
Una fuente ampliamente utilizada es GBIF , que facilita acceso a millones de registros de biodiversidad. Sin embargo, esos datos deben pasar por un proceso de depuración antes del modelamiento.
2. Las variables ambientales deben tener sentido ecológico
En un análisis de distribución de especies con Python e IA, las variables ambientales no deben seleccionarse únicamente porque estén disponibles.
Deben existir razones ecológicas para pensar que esas variables pueden influir en la distribución o idoneidad de la especie.
Recursos como WorldClim permiten incorporar variables bioclimáticas utilizadas en numerosos estudios ecológicos.
3. El sesgo espacial puede producir modelos aparentemente excelentes
Los registros de biodiversidad rara vez provienen de un muestreo completamente aleatorio.
Es habitual encontrar mayores concentraciones de observaciones cerca de carreteras, ciudades, estaciones biológicas o zonas de fácil acceso.
Si este patrón no se considera, el modelo puede aprender características relacionadas con el esfuerzo de muestreo en lugar de relaciones ecológicas reales.
4. No existe un único algoritmo correcto
Una vez preparados los registros y variables, comienza la etapa de modelamiento.
En la distribución de especies con Python e IA conviene comparar alternativas en lugar de depender automáticamente de un único algoritmo.
- Random Forest;
- Gradient Boosting;
- máquinas de vectores de soporte;
- modelos estadísticos;
- redes neuronales;
- métodos de ensamble.
Por ejemplo, Random Forest en Scikit-learn permite construir modelos supervisados y analizar la importancia de los predictores.
5. La validación espacial pone realmente a prueba al modelo
Uno de los errores más frecuentes consiste en dividir aleatoriamente registros que se encuentran muy próximos geográficamente.
El resultado puede ser una precisión artificialmente elevada, porque los puntos de validación son muy parecidos a los utilizados en entrenamiento.
En estudios de distribución de especies con Python e IA, la validación espacial por bloques puede proporcionar una evaluación mucho más exigente.
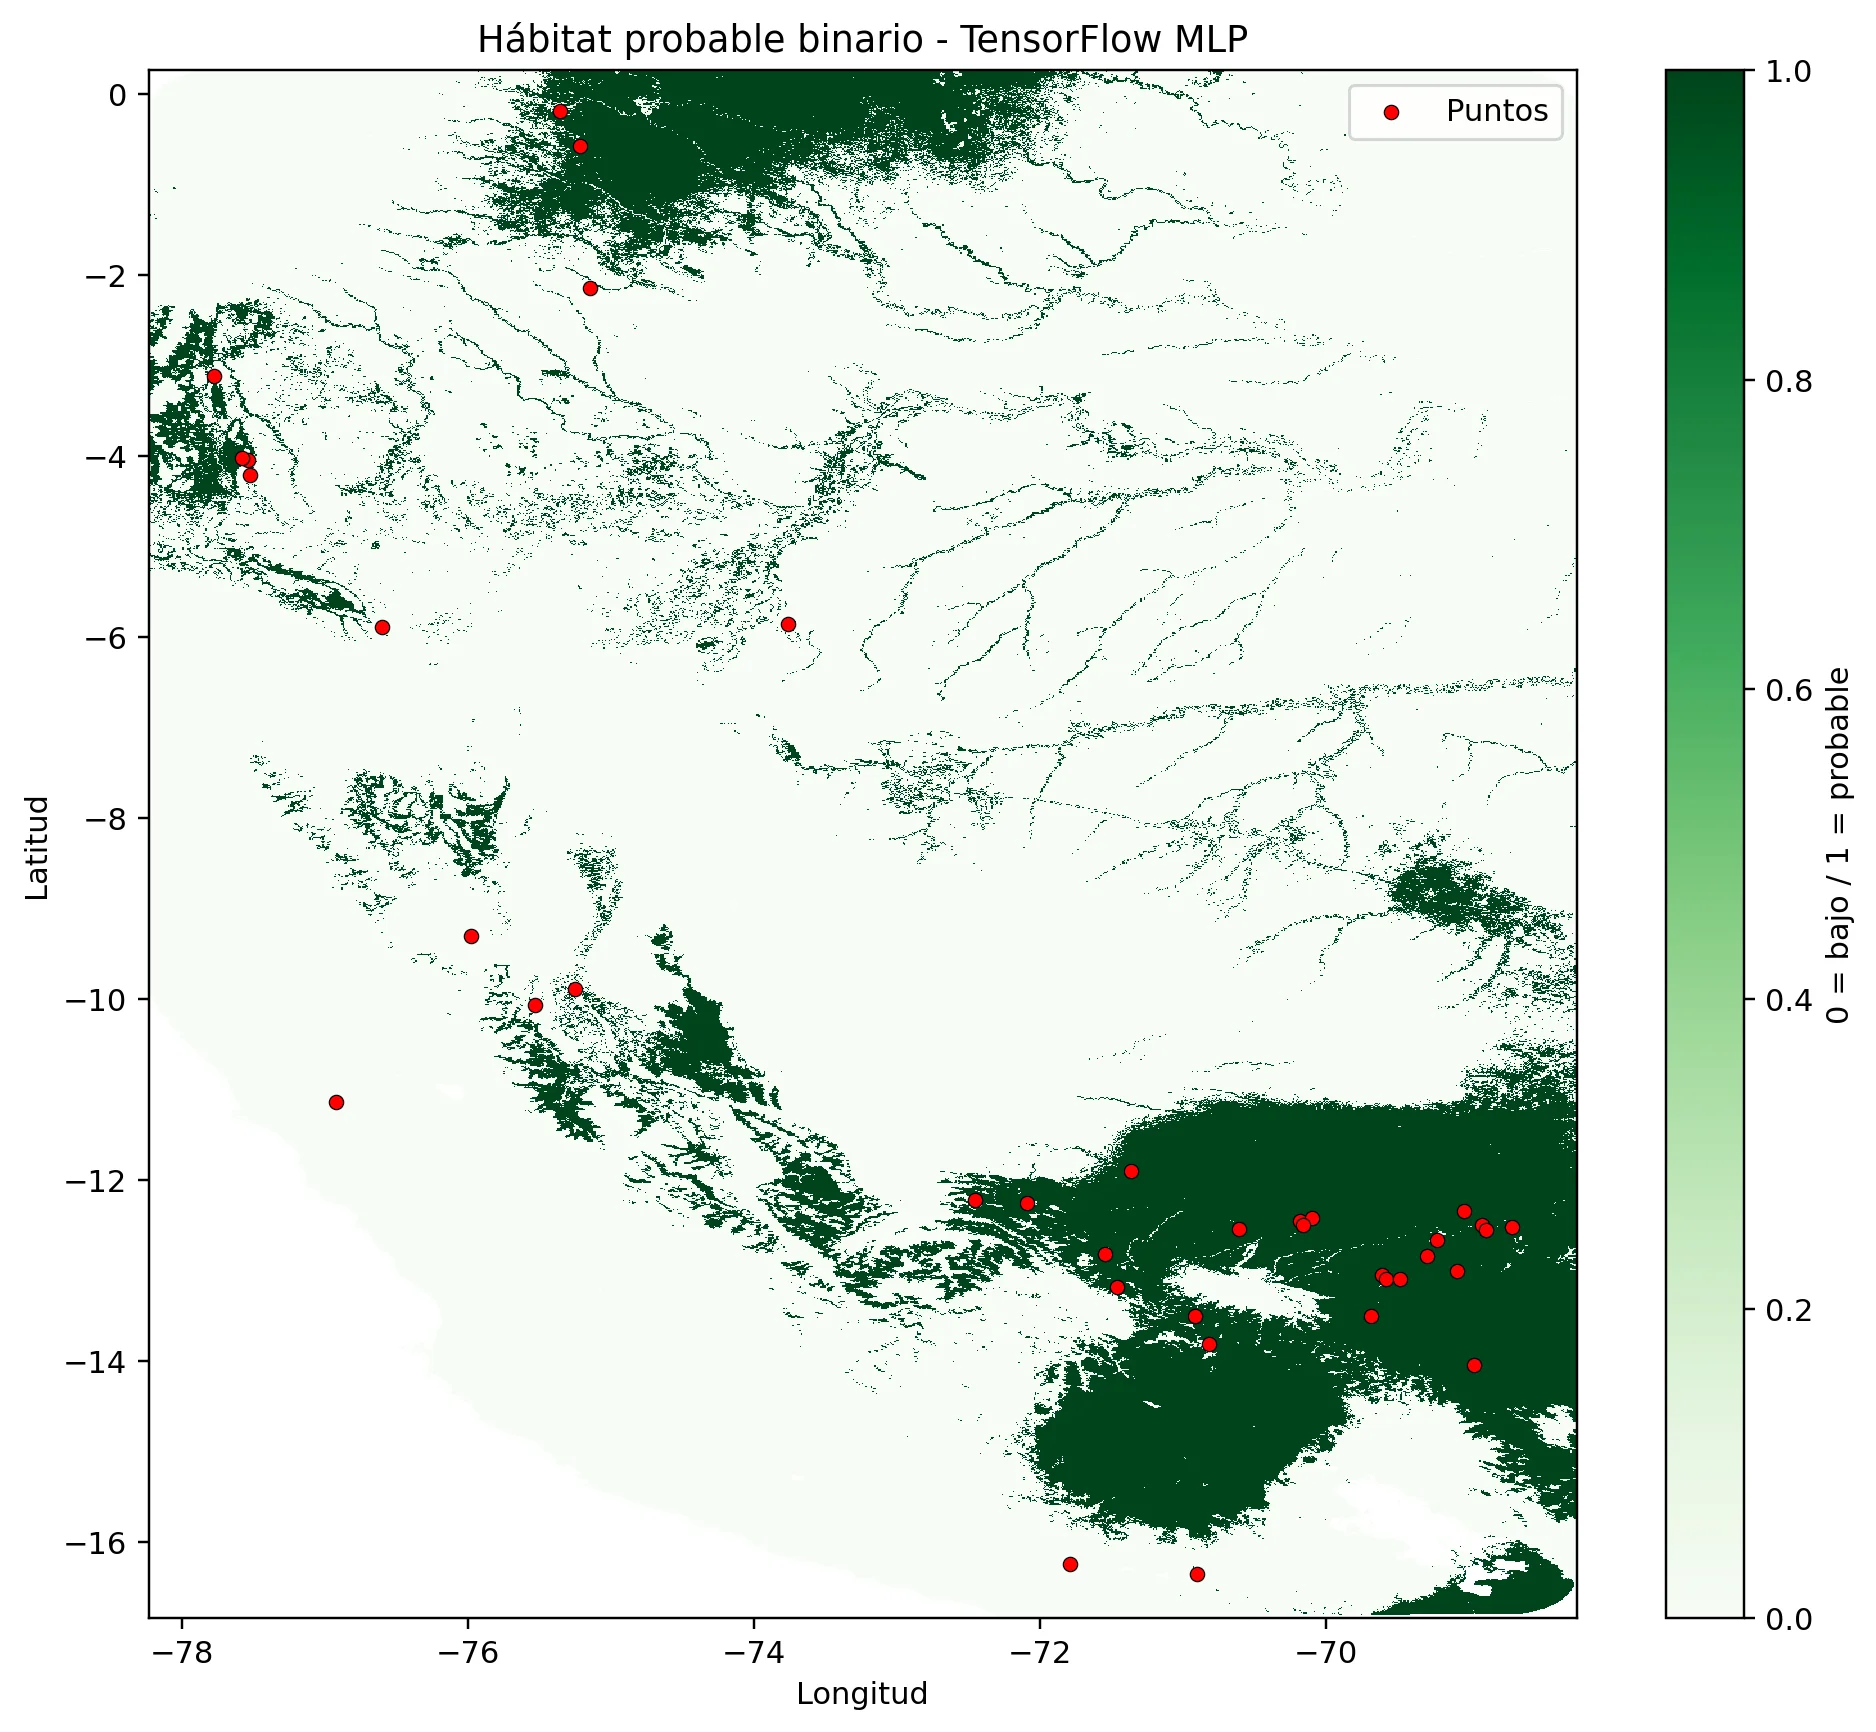
6. Un mapa continuo contiene más información que una clasificación binaria
Muchos modelos generan una superficie continua donde cada píxel representa un determinado nivel de idoneidad ambiental.
Convertir inmediatamente ese resultado en adecuado/no adecuado puede eliminar información relevante.
Cuando sea necesario producir un mapa binario, el umbral debe seleccionarse mediante criterios compatibles con el objetivo del estudio.
7. Un flujo reproducible es más valioso que un mapa aislado
Una metodología sólida debe permitir reconstruir cómo se obtuvo el resultado.
Una estrategia reproducible de distribución de especies con Python e IA debe documentar los datos, variables, algoritmos, parámetros y métodos de validación empleados.
Preguntas frecuentes
¿La IA puede decir exactamente dónde se encuentra una especie?
No. Puede estimar dónde existen condiciones ambientalmente favorables según los datos utilizados, pero no confirma por sí sola la presencia real.
¿Random Forest sirve para modelar distribución de especies?
Sí. Puede utilizarse como uno de varios algoritmos, pero su desempeño debe evaluarse mediante una estrategia adecuada de validación.
¿Las imágenes satelitales pueden aportar variables ambientales?
Sí. Pueden aportar información sobre vegetación, humedad, cobertura terrestre, fenología y otras características relacionadas con el hábitat.
¿Por qué utilizar Python?
Python permite automatizar, reproducir y escalar distintas etapas del análisis, desde la preparación de los datos hasta el entrenamiento y la validación.
Del dato biológico a una hipótesis ecológica espacial
La distribución de especies con Python e IA conecta ecología, ciencia de datos y análisis geográfico.
Aplicada correctamente, la distribución de especies con Python e IA puede apoyar estudios de biodiversidad, conservación, planificación ambiental y priorización territorial.
Pero el verdadero valor no está únicamente en obtener un mapa atractivo. Está en comprender de dónde proceden los registros, qué representan las variables, qué aprendió el modelo, cómo fue validado y cuáles son sus límites.
Lleva estos conceptos a la práctica y fortalece tus habilidades en Ciencia de Datos e Inteligencia Artificial Ambiental
Si llegaste hasta aquí, ya viste que la distribución de especies con Python e IA requiere mucho más que ejecutar un algoritmo.
El verdadero desafío es aprender a conectar datos, análisis espacial, teledetección, modelamiento y validación dentro de un flujo técnicamente coherente.
Por eso hemos preparado un seminario gratuito con certificación para profesionales, investigadores, estudiantes y consultores que quieren fortalecer sus capacidades en Ciencia de Datos, SIG e Inteligencia Artificial aplicada al análisis ambiental.
Reserva tu acceso gratuito
Completa el formulario y te enviaremos la información necesaria para participar.
✓ Participación gratuita · ✓ Certificación · ✓ Big Data Academy
¿Quieres profundizar después del seminario?
El seminario gratuito puede ser tu punto de partida. Si posteriormente deseas avanzar con una formación más profunda y aplicada, puedes explorar nuestros programas especializados.
Python e IA para Ecología y Bosques
Profundiza en Python, Ciencia de Datos e Inteligencia Artificial aplicada a biodiversidad, ecología y análisis forestal.
Conocer el programa →Monitoreo de Bosques con Google Earth Engine
Trabaja con imágenes satelitales, análisis multitemporal y Google Earth Engine para estudiar la dinámica de los bosques.
Conocer el programa →Ecología Espacial con Google Earth Engine
Integra ecología, variables ambientales, análisis espacial y teledetección para estudiar patrones a escala territorial.
Conocer el programa →