
Distribución de especies con Python e IA: 7 claves para modelar hábitat y nicho probable
Aprende cómo integrar registros biológicos, variables ambientales y modelos predictivos para estimar la distribución potencial de una especie con un enfoque ecológico reproducible.
La distribución de especies con Python e IA combina observaciones biológicas con información ambiental para estimar qué zonas presentan condiciones favorables para una especie. El resultado no confirma presencia: genera una hipótesis espacial que debe validarse.
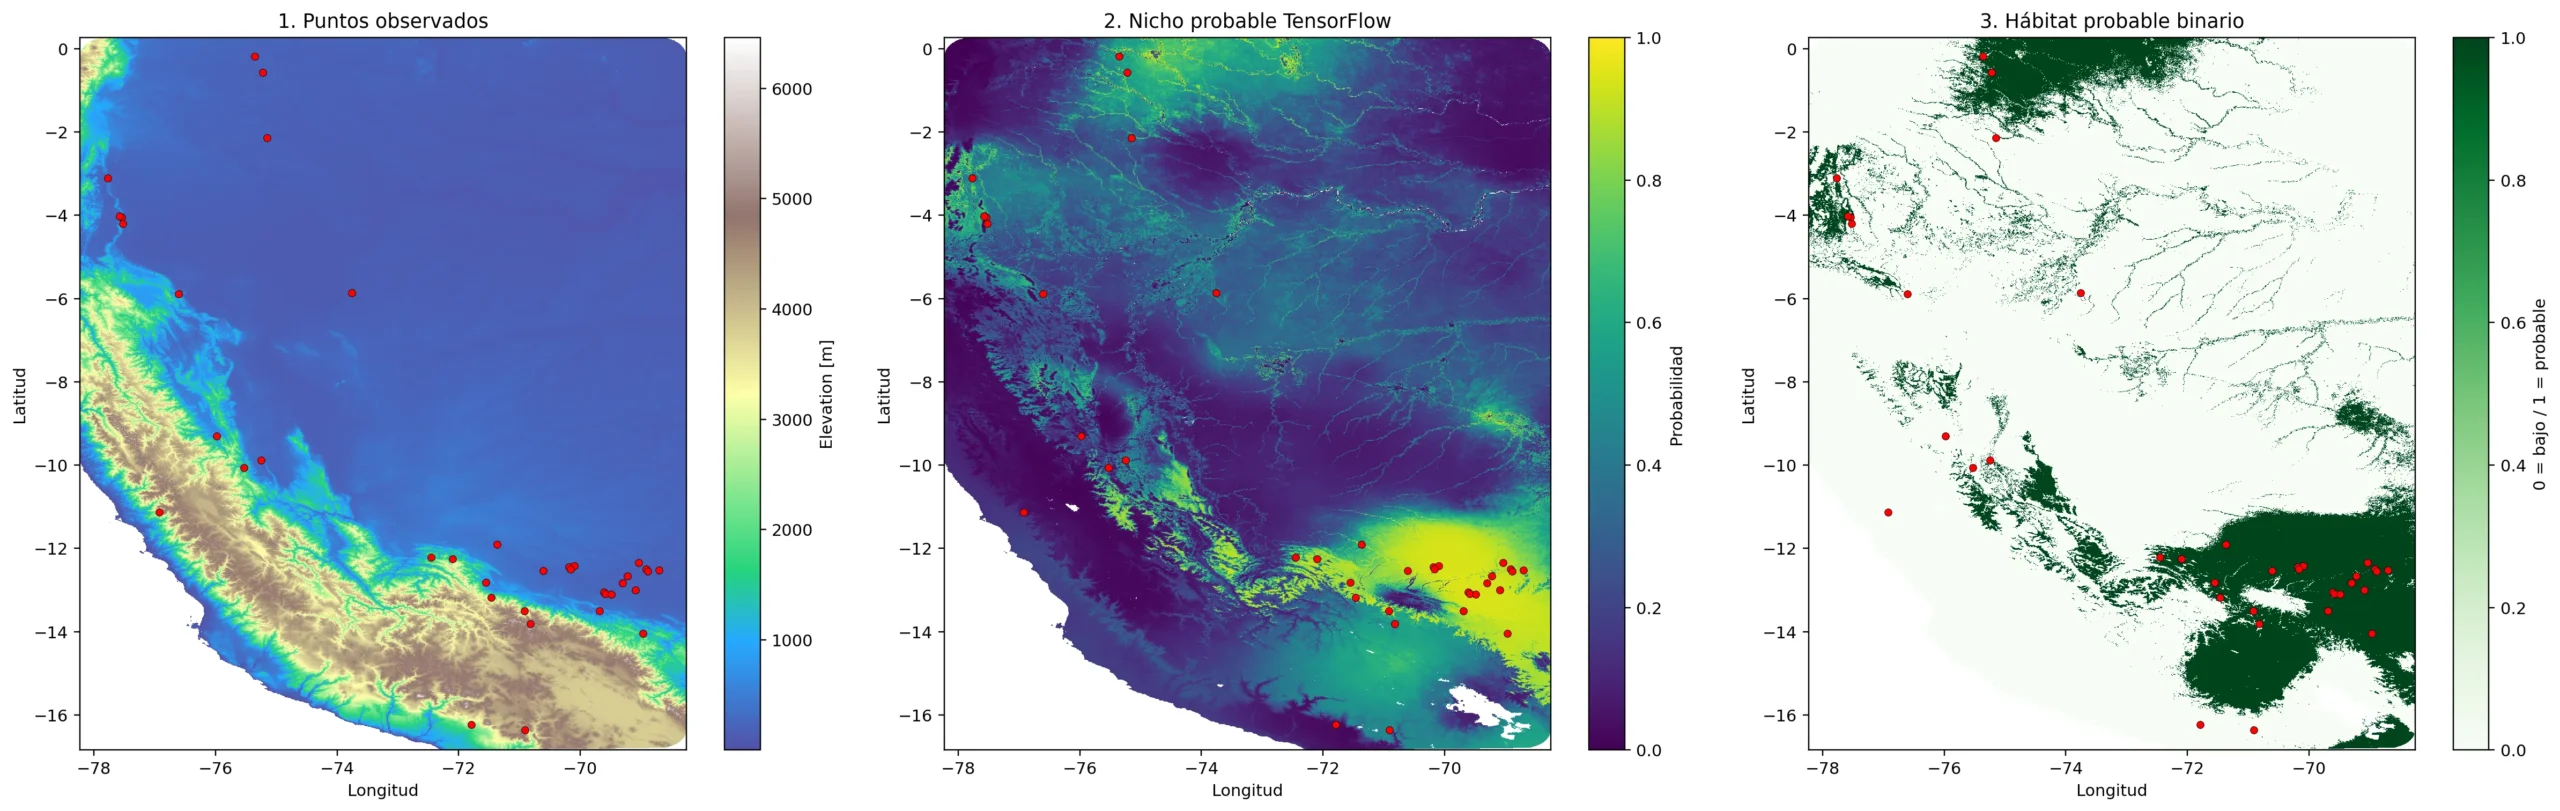
¿Cómo funciona la distribución de especies con Python e IA?
Supongamos que conocemos distintos lugares donde una especie ha sido registrada. Cada registro se encuentra asociado con determinadas condiciones de temperatura, precipitación, elevación, vegetación y cobertura terrestre.
Un modelo puede analizar esas relaciones y estimar qué otros territorios presentan condiciones ambientales semejantes.
De esta manera, la distribución de especies con Python e IA transforma registros biológicos en una hipótesis espacial sobre dónde podrían existir condiciones favorables.
1. Los registros biológicos definen el punto de partida
Todo proyecto de distribución de especies con Python e IA necesita comenzar con registros confiables.
Una gran cantidad de observaciones no garantiza una buena representación ecológica. Antes de entrenar un modelo conviene revisar:
- exactitud de las coordenadas;
- identificación taxonómica;
- registros duplicados;
- errores de georreferenciación;
- fecha de observación;
- concentración espacial del muestreo;
- sesgos relacionados con accesibilidad.
Una fuente ampliamente utilizada es GBIF , que permite acceder a grandes volúmenes de registros de biodiversidad.
2. Las variables ambientales deben tener sentido ecológico
En un análisis de distribución de especies con Python e IA, las variables no deberían seleccionarse únicamente porque estén disponibles.
Deben existir razones ecológicas para pensar que influyen en la presencia o idoneidad de la especie.
Recursos como WorldClim permiten incorporar variables bioclimáticas utilizadas en numerosos estudios ecológicos.
3. El sesgo espacial puede engañar al modelo
Los registros de biodiversidad rara vez proceden de un muestreo perfectamente aleatorio.
Es común encontrar más observaciones cerca de carreteras, centros poblados, estaciones biológicas o lugares de fácil acceso.
Si este patrón no se controla, el algoritmo puede aprender dónde fue más fácil observar la especie en lugar de aprender relaciones ecológicas reales.
4. No existe un único algoritmo correcto
Una vez preparados los registros y las variables, comienza la etapa de modelamiento.
En la distribución de especies con Python e IA conviene comparar diferentes enfoques.
- Random Forest;
- Gradient Boosting;
- máquinas de vectores de soporte;
- modelos estadísticos;
- redes neuronales;
- métodos de ensamble.
Por ejemplo, Random Forest en Scikit-learn permite construir modelos supervisados y analizar la importancia relativa de distintos predictores.
5. La validación espacial pone realmente a prueba al modelo
Uno de los errores más frecuentes consiste en dividir aleatoriamente registros que se encuentran muy próximos geográficamente.
El resultado puede ser una precisión artificialmente elevada, porque los datos de validación se parecen demasiado a los utilizados durante el entrenamiento.
En estudios de distribución de especies con Python e IA, la validación espacial por bloques puede proporcionar una evaluación mucho más realista.
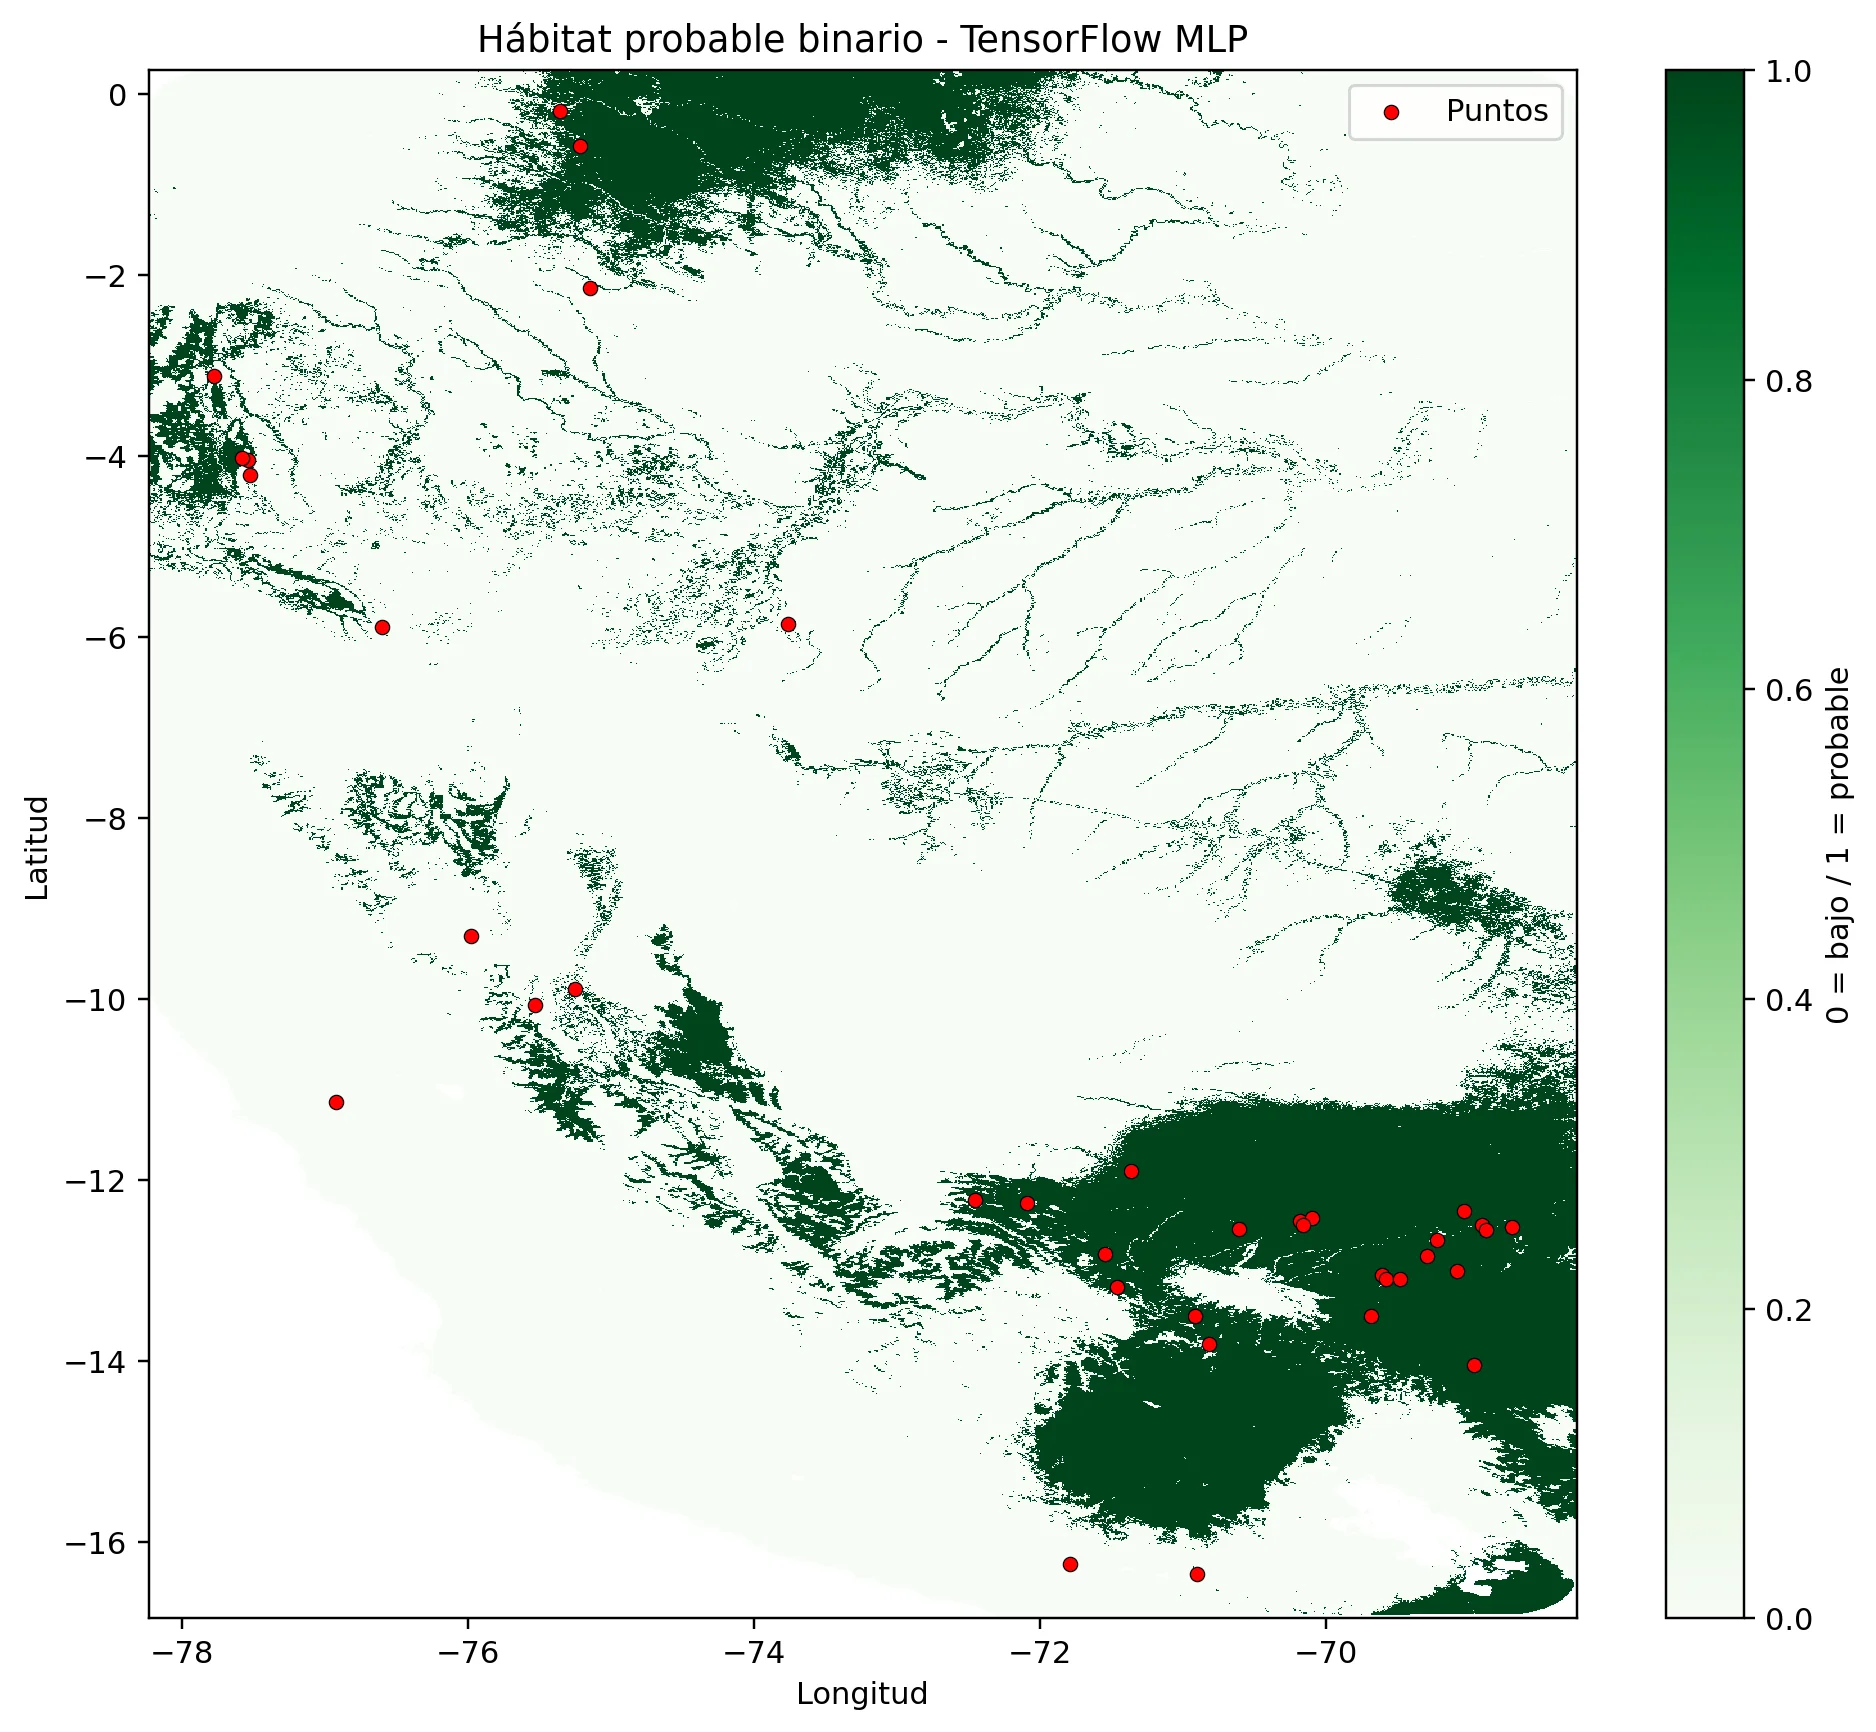
6. Un mapa continuo contiene más información que un simple sí o no
Muchos modelos producen una superficie continua donde cada píxel representa un nivel de idoneidad ambiental.
Convertir inmediatamente ese resultado en adecuado o no adecuado puede eliminar información relevante.
Cuando se necesite un mapa binario, el umbral debe seleccionarse mediante criterios compatibles con el objetivo del estudio.
7. Un flujo reproducible vale más que un mapa aislado
Una metodología seria de distribución de especies con Python e IA debe documentar los datos, variables, algoritmos, parámetros y métodos de validación empleados.
Del registro biológico a una hipótesis ecológica espacial
La distribución de especies con Python e IA conecta ecología, ciencia de datos y análisis geográfico.
Su verdadero valor no está únicamente en producir un mapa atractivo, sino en comprender de dónde proceden los datos, qué representan las variables, qué aprendió el modelo y cuáles son los límites de la predicción.
Cuando estas etapas se integran correctamente, el resultado puede apoyar investigación, conservación, priorización territorial y toma de decisiones ambientales.
Lleva estos conceptos a la práctica
Si quieres fortalecer tus habilidades en Ciencia de Datos, SIG, teledetección e Inteligencia Artificial aplicada al análisis ambiental, puedes comenzar gratuitamente en nuestro próximo seminario.
Reserva tu acceso gratuito
Completa tus datos y te enviaremos la información para participar.
Participación gratuita · Certificación · Big Data Academy
¿Quieres seguir profundizando?
Si después del seminario quieres continuar desarrollando estas habilidades, puedes explorar nuestros programas especializados.
Python e IA para Ecología y Bosques
Ciencia de datos e Inteligencia Artificial aplicada a biodiversidad, ecología y análisis forestal.
Ver programa →Monitoreo de Bosques con Google Earth Engine
Imágenes satelitales, análisis multitemporal y monitoreo de bosques.
Ver programa →Ecología Espacial con Google Earth Engine
Ecología, variables ambientales, análisis espacial y teledetección.
Ver programa →